Roman Bachmann — ML Research Scientist

Hi! I'm Roman Bachmann, a Machine Learning Research Scientist at Apple. My research is focused on building scalable any-to-any multimodal foundation models for world modelling and visual reasoning. My goal is to build adaptable world priors that enable quick understanding of the environment and allow for global, out-of-sight reasoning.

Previously I was an EPFL PhD student at VILAB, advised by Amir Zamir. I received my M.Sc. degree in Data Science at EPFL, where I also completed my B.Sc. in Computer Science. During my studies, I interned as a research scientist at Apple and RIKEN AIP.

Highlighted publications
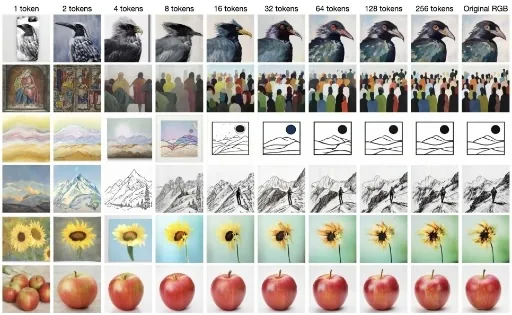

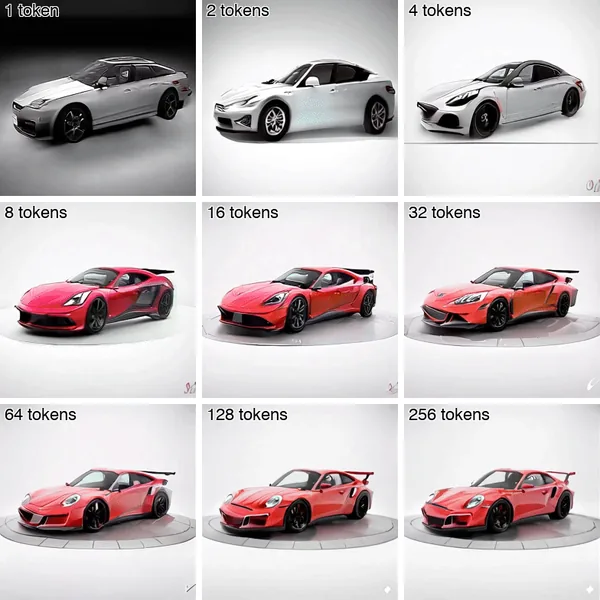
FlexTok: Resampling Images into 1D Token Sequences of Flexible Length →

Roman Bachmann*, Jesse Allardice*, David Mizrahi*, Enrico Fini, Oğuzhan Fatih Kar, Elmira Amirloo, Alaaeldin El-Nouby, Amir Zamir, Afshin Dehghan

ICML 2025

FlexTok: Resampling Images into 1D Token Sequences of Flexible Length

4M-21: An Any-to-Any Vision Model for Tens of Tasks and Modalities →

Roman Bachmann*, Oğuzhan Fatih Kar*, David Mizrahi*, Ali Garjani, Mingfei Gao, David Griffiths, Jiaming Hu, Afshin Dehghan, Amir Zamir

NeurIPS 2024

★ >1.8k stars on GitHub

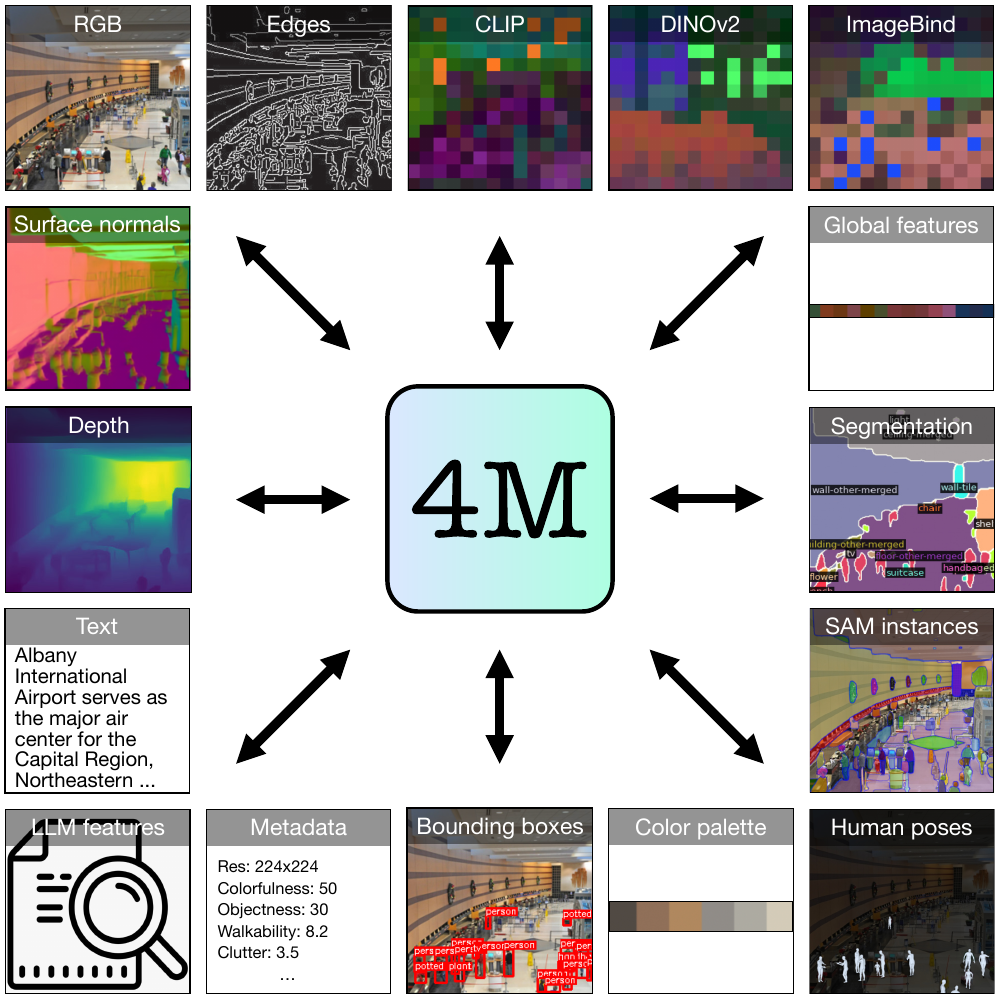
4M-21: An Any-to-Any Vision Model for Tens of Tasks and Modalities

4M: Massively Multimodal Masked Modeling →

David Mizrahi*, Roman Bachmann*, Oğuzhan Fatih Kar, Teresa Yeo, Mingfei Gao, Afshin Dehghan, Amir Zamir

NeurIPS 2023

★ Spotlight

4M: Massively Multimodal Masked Modeling

MultiMAE: Multi-modal Multi-task Masked Autoencoders →

Roman Bachmann*, David Mizrahi*, Andrei Atanov, Amir Zamir

ECCV 2022

MultiMAE: Multi-modal Multi-task Masked Autoencoders

All publications

2026


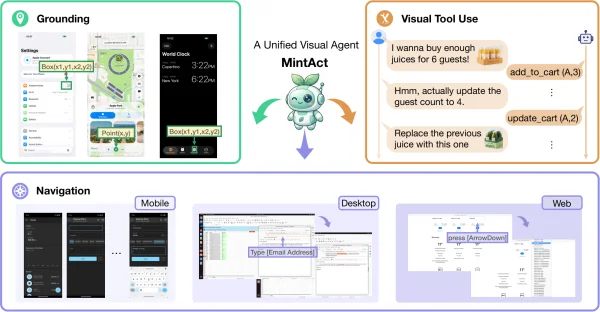
MintAct: A Unified Visual Agent for Digital Environments →

Mingfei Gao, Rui Tian, Haiming Gang, Bohan Zhai, Le Zhang, Yuanzheng Gong, Di Feng, Ege Özsoy, Kaixin Ma, Vishwesh Kirthivasan, Oğuzhan Fatih Kar, Roman Bachmann, Anders Boesen Lindbo Larsen, Afshin Dehghan

Under review

MintAct: A Unified Visual Agent for Digital Environments

Weblica: Scalable and Reproducible Training Environments for Visual Web Agents →

Oğuzhan Fatih Kar, Roman Bachmann, Yuanzheng Gong, Anders Boesen Lindbo Larsen, Afshin Dehghan

Under review

Weblica: Scalable and Reproducible Training Environments for Visual Web Agents

OmniDiMM: Bridging 1D, 2D, and 3D with Any-to-Any Multimodal Modeling →

Jason Toskov*, Oriol Barbany*, Rishubh Singh*, Jinya Sakurai, Efe Tarhan, Oğuzhan Fatih Kar, Roman Bachmann, Amir Zadeh, Jesse Allardice, Chuan Li, Carme Torras, Afshin Dehghan, Amir Zamir

NeurIPS 2026

Any-to-Any Video Modeling: Modeling the World by Traversing Time and Modalities →

Muhammad Uzair Khattak, Won Jun Kim, Reza Abbasi, Albias Havolli, Michael Murphy, Amir Zadeh, Chuan Li, Muhammad Ferjad Naeem, Oğuzhan Fatih Kar, Roman Bachmann, Andrei Atanov, Federico Tombari, Amir Zamir

Under review

MODUS: Decoder-only Any-to-Any Modeling of Diverse Modalities →

Mingqiao Ye*, Zhaochong An*, Zhitong Gao, Xian Liu, François Fleuret, Chuan Li, Amir Zadeh, Serge Belongie, Afshin Dehghan, Jesse Allardice†, David Mizrahi†, Oğuzhan Fatih Kar†, Roman Bachmann†, Amir Zamir

ICML 2026

MODUS: Decoder-only Any-to-Any Modeling of Diverse Modalities

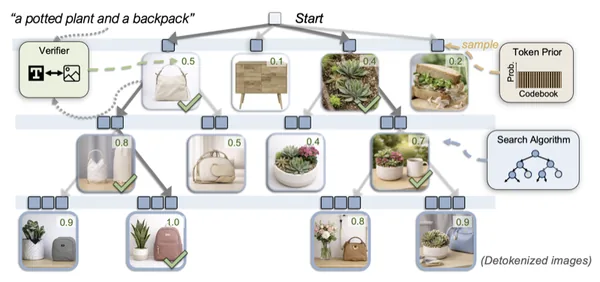
(1D) Ordered Tokens Enable Efficient Test-Time Search →

Zhitong Gao, Parham Rezaei, Ali Cy, Mingqiao Ye, Nataša Jovanović, Jesse Allardice, Afshin Dehghan, Amir Zamir, Roman Bachmann†, Oğuzhan Fatih Kar†

ICML 2026

(1D) Ordered Tokens Enable Efficient Test-Time Search

VideoFlexTok: Flexible-Length Coarse-to-Fine Video Tokenization →

Andrei Atanov*, Jesse Allardice*, Roman Bachmann, Oğuzhan Fatih Kar, R Devon Hjelm, David Griffiths, Peter Fu, Afshin Dehghan, Amir Zamir

ICML 2026

★ Spotlight

VideoFlexTok: Flexible-Length Coarse-to-Fine Video Tokenization

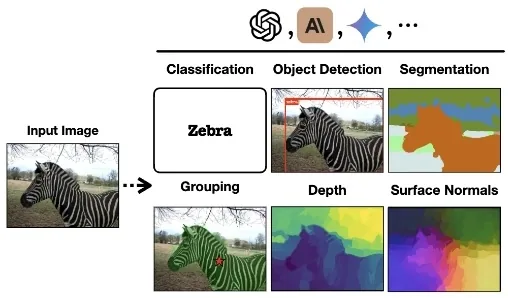
How Well Does GPT-4o Understand Vision? Evaluating Multimodal Foundation Models on Standard Computer Vision Tasks →

Rahul Ramachandran, Ali Garjani, Roman Bachmann, Andrei Atanov†, Oğuzhan Fatih Kar†, Amir Zamir†

ICLR 2026

How Well Does GPT-4o Understand Vision? Evaluating Multimodal Foundation Models on Standard Computer Vision Tasks

2025


FlexTok: Resampling Images into 1D Token Sequences of Flexible Length →

Roman Bachmann*, Jesse Allardice*, David Mizrahi*, Enrico Fini, Oğuzhan Fatih Kar, Elmira Amirloo, Alaaeldin El-Nouby, Amir Zamir, Afshin Dehghan

ICML 2025

FlexTok: Resampling Images into 1D Token Sequences of Flexible Length

2024


4M-21: An Any-to-Any Vision Model for Tens of Tasks and Modalities →

Roman Bachmann*, Oğuzhan Fatih Kar*, David Mizrahi*, Ali Garjani, Mingfei Gao, David Griffiths, Jiaming Hu, Afshin Dehghan, Amir Zamir

NeurIPS 2024

★ >1.8k stars on GitHub

4M-21: An Any-to-Any Vision Model for Tens of Tasks and Modalities

ViPer: Visual Personalization of Generative Models via Individual Preference Learning →

Sogand Salehi, Mahdi Shafiei, Teresa Yeo, Roman Bachmann, Amir Zamir

ECCV 2024

★ Demoed at ECCV 2024, Milan
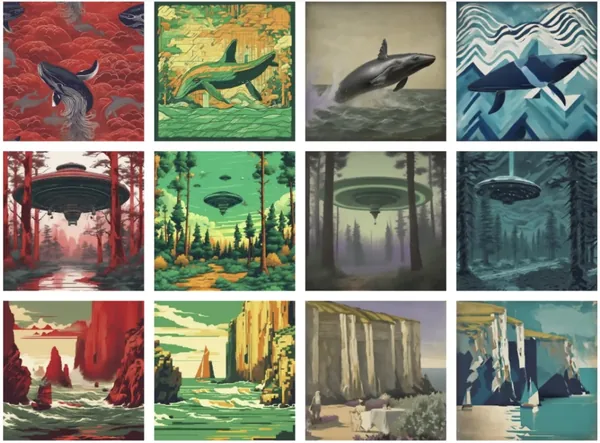
ViPer: Visual Personalization of Generative Models via Individual Preference Learning

2023


4M: Massively Multimodal Masked Modeling →

David Mizrahi*, Roman Bachmann*, Oğuzhan Fatih Kar, Teresa Yeo, Mingfei Gao, Afshin Dehghan, Amir Zamir

NeurIPS 2023

★ Spotlight

4M: Massively Multimodal Masked Modeling

2022


MultiMAE: Multi-modal Multi-task Masked Autoencoders →

Roman Bachmann*, David Mizrahi*, Andrei Atanov, Amir Zamir

ECCV 2022

MultiMAE: Multi-modal Multi-task Masked Autoencoders

CLIPasso: Semantically-Aware Object Sketching →

Yael Vinker, Ehsan Pajouheshgar, Jessica Y. Bo, Roman Bachmann, Amit Haim Bermano, Daniel Cohen-Or, Amir Zamir, Ariel Shamir

SIGGRAPH 2022

★ Best Paper Award winner

CLIPasso: Semantically-Aware Object Sketching

2021


Omnidata: A Scalable Pipeline for Making Multi-Task Mid-Level Vision Datasets from 3D Scans →

Ainaz Eftekhar*, Alexander Sax*, Roman Bachmann, Jitendra Malik, Amir Zamir

ICCV 2021

Omnidata: A Scalable Pipeline for Making Multi-Task Mid-Level Vision Datasets from 3D Scans

2020


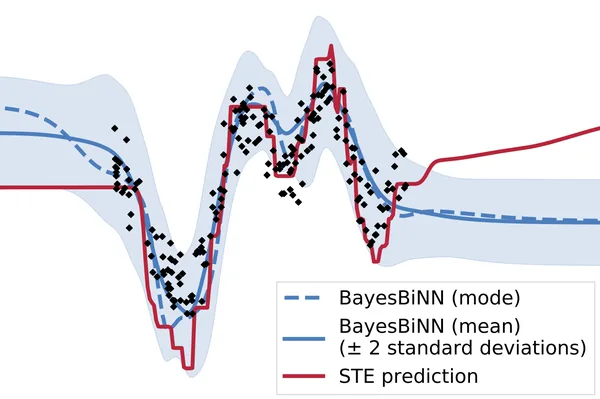
Training Binary Neural Networks using the Bayesian Learning Rule →

Xiangming Meng, Roman Bachmann, Mohammad Emtiyaz Khan

ICML 2020

Training Binary Neural Networks using the Bayesian Learning Rule

2019


Motion Capture from Pan-Tilt Cameras with Unknown Orientation →

Roman Bachmann, Jörg Spörri, Pascal Fua, Helge Rhodin

3DV 2019

★ Selected for oral presentation
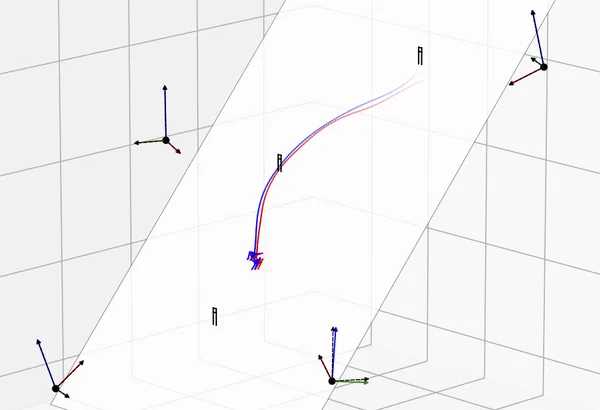
Motion Capture from Pan-Tilt Cameras with Unknown Orientation

Global Motion Estimation from Pan-Tilt Cameras →

Roman Bachmann; supervised by Helge Rhodin and Pascal Fua

CESCG 2019 (non-peer-reviewed)

★ Voted best presentation and third best paper
Global Motion Estimation from Pan-Tilt Cameras

Automatic 3D motion capture in alpine skiing using deep learning and computer vision →

Roman Bachmann, Helge Rhodin, Jörg Spörri, Pascal Fua

ICSS 2019 (conference abstract, p. 14, non-peer-reviewed)

★ Won first place in the Young Investigator Award competition
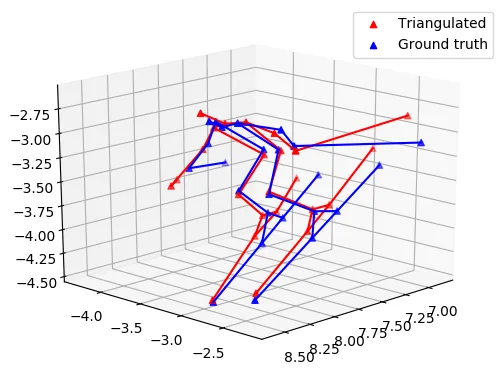
Automatic 3D motion capture in alpine skiing using deep learning and computer vision

* Equal contribution.   † Equal technical advising.